91점
Results for mm malloc:
trace  valid  util     ops      secs  Kops
 0       yes   99%    5694  0.000097 58883
 1       yes   99%    5848  0.000137 42593
 2       yes   99%    6648  0.000125 53014
 3       yes   99%    5380  0.000108 49907
 4       yes   66%   14400  0.000128112588
 5       yes   96%    4800  0.002112  2273
 6       yes   95%    4800  0.002148  2234
 7       yes   55%   12000  0.039567   303
 8       yes   51%   24000  0.044914   534
 9       yes   95%   14401  0.000110131276
10       yes   75%   14401  0.000072199184
Total          85%  112372  0.089518  1255

Perf index = 51 (util) + 40 (thru) = 91/100
94점
 1       yes   99%    5848  0.000132 44236
 2       yes   99%    6648  0.000152 43651
 3       yes   99%    5380  0.000113 47822
 4       yes   66%   14400  0.000128112941
 5       yes   95%    4800  0.002264  2120
 6       yes   95%    4800  0.002106  2279
 7       yes   95%   12000  0.005402  2222
 8       yes   88%   24000  0.005127  4681
 9       yes   99%   14401  0.000076189987
10       yes   62%   14401  0.000066217210
Total          91%  112372  0.015745  7137

Perf index = 54 (util) + 40 (thru) = 94/10
91 → 94점 개선 트러블 슈팅
처리량점수는 최대,Util을 올렸어야 함
점수가 낮았던 Trace
a 0 16
a 1 112
a 2 16
a 3 112
a 4 16
a 5 112
a 6 16
a 7 112
a 8 16
a 9 112
a 10 16
a 11 112
a 12 16
a 13 112
a 14 16
a 15 112- 이런 식의
작은크기의 블록과큰크기의 블록이 반복되며단편화를 유도하는Trace
해결 방법은?
작은크기의 블록과큰크기의 블록 반복 시의외부 단편화를 해결해야 함
기존 Place 함수
할당 후:  [S][L][S][L][S][L][S][L][  free  ]
L free:   [S][ ][S][ ][S][ ][S][ ][  free  ]
           → 구멍들이 S에 막혀서 합쳐지지 않음
           → 더 큰 요청이 오면 들어갈 곳이 없어 힙 확장(sbrk)
변경 Place 함수
할당 후:  [S][S][S][S][   free   ][L][L][L][L]
L free:   [S][S][S][S][      하나의 큰 free 블록      ]
           → 해제된 L들이 연속으로 붙어 있어 하나로 coalesce
           → 큰 요청도 기존 공간에서 처리 가능
변경 Place 함수 로직
size_t origin_size = GET_SIZE(HDRP(bp));
    remove_free_block(bp);

    // total_size += size;
    // total_n += 1;
    // threshold = (threshold * 0.5) + 0.5*((double)total_size / total_n);
    hist[size_bin(size)]++;
    if ((++n_alloc & 63) == 0)
        threshold = otsu_threshold();

    if ((origin_size - size) < MIN_BLOCK_SIZE)
    {
        PUT(HDRP(bp), PACK(origin_size, 1));
        PUT(FTRP(bp), PACK(origin_size, 1));
        return bp;
    }
    else if (size >= threshold)
    {
        PUT(HDRP(bp), PACK(origin_size - size, 0));
        PUT(FTRP(bp), PACK(origin_size - size, 0));
        insert_free_block(bp);

        bp = NEXT_BLKP(bp);
        PUT(HDRP(bp), PACK(size, 1));
        PUT(FTRP(bp), PACK(size, 1));
        return bp;
    }
    else
    {
        PUT(HDRP(bp), PACK(size, 1));
        PUT(FTRP(bp), PACK(size, 1));

        PUT(HDRP(NEXT_BLKP(bp)), PACK(origin_size - size, 0));
        PUT(FTRP(NEXT_BLKP(bp)), PACK(origin_size - size, 0));
        insert_free_block(NEXT_BLKP(bp));
        return bp;
    }
로직
Threshold (임계값) 기준
Threshold > size라면
- 기존 place 함수와 동일하게 왼쪽에 블록 할당
Threshold ≤ size라면
- 오른쪽에 블록 할당
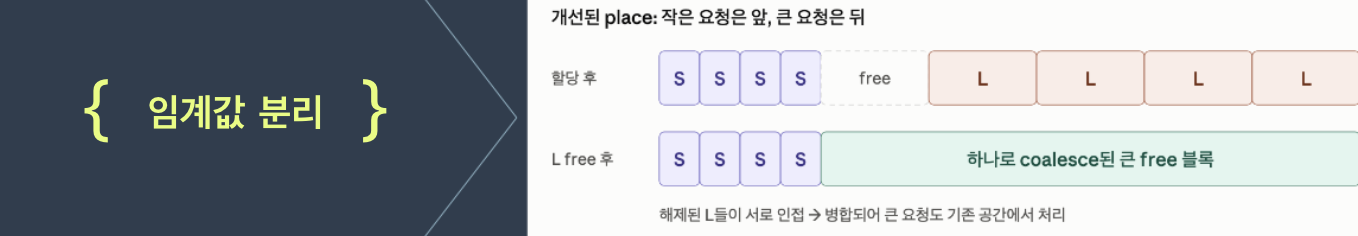
free 시 공간이 쪼개져 있는 형태가 아닌 하나의 큰 가용 블록을 얻기 위함
임계값을 정하는 부분이 조금은 난잡 (3가지 방법)
// total_size += size;
    // total_n += 1;
    // threshold = (threshold * 0.5) + 0.5*((double)total_size / total_n);
    hist[size_bin(size)]++;
    if ((++n_alloc & 63) == 0)
threshold = otsu_threshold();- 고정값 (100)
(threshold * 0.5) + 0.5*((double)total_size / total_n)기존에다가 입력되어 들어오는 size를 0.5로 업데이트Otsu (오츠) 알고리즘사용- 임계값을 따로 정하지 않음
- 클래스 간의 분산 최대화
하지만
임계값을 구하는 로직을 개선하더라도 Util값이 증가하지는 않음
임계값 개선이 Util 향상으로 이어지지 않는 이유
임계값을 구하는 로직을 정교하게 다듬더라도 메모리 이용률(Util)은 크게 오르지 않음
Util을 높이려면 힙의 최대 크기를 늘리지 않고, 이미 해제된 가용 메모리를 최대한 재활용해야함
할당 요청이 들어오는 바로 그 시점에 요청을 감당할 만큼 충분히 큰 가용 블록이 존재해야함. 이를 위해서는 블록이 해제될 때 인접한 블록도 함께 비어 있어 병합이 일어나야 하고 병합된 결과가 이후 요청에 실제로 쓰일 수 있을 만큼의 크기를 가져야 한다.
즉 Util은 해제 순서와 블록의 물리적 배치, 그리고 그로 인한 단편화 정도에 의해 결정된다.
반면 임계값은 가용 블록들을 크기 분포에 따라 분산이 고르게 유지되도록 잘 나누는 역할을 함. 이는 블록을 어느 그룹에 둘지를 정하는 분류의 문제이지, 인접 블록이 함께 해제되어 큰 공간이 만들어지는지와는 직접적인 관련이 없다. 따라서 임계값이 최적화되는 방향과 Util이 개선되는 방향 사이에는 거리가 있다.
이를 달리 표현하면, 임계값이 "충분히 괜찮은" 수준으로 블록을 나누고 있다면 그 이상 정교한 임계값은 Util 개선에 기여하지 못할 수 있다. 분리 품질이 일정 수준을 넘어서면, 이후의 성능은 임계값이 아니라 배치 정책과 병합 효율에 의해 좌우되기 때문이다.
결론
Place 함수 개선을 통한 단편화 극복은 성공적이었으나 임계값을 통한 Util 향상은 방향성이 다르다
시리즈에서 이어 읽기 · Malloc Lab →